Стартовая страница › Форумы › Новые идеи › Scada Server. Текст (предложение)
- В этой теме 43 ответа, 3 участника, последнее обновление 2 недели, 3 дня назад сделано
 manjey73.
-
АвторЗаписи
-
02.10.2026 в 19:17 #45230
 manjey73Участник
Как не пересекаются, епт, а если это строка их устройства и ты хочешь посмотреть за период?
Прочти внимательно ещё раз, ты id в словаре можешь делать тем же, что и id канала. Слова от этого ни холодно, ни жарко
02.10.2026 в 19:31 #45231manjey73УчастникСловаРЮ от этого ни холодно, ни жарко
02.10.2026 в 19:38 #45232 JurasskParkУчастник
И в чем проблема?
Ты хочешь сказать, что при выборке данных за несколько дней, сервер не идет по каждой папке и не читает meta?Зашел в папку 20200101.
Номер канала 50, при выборке id словаря 56, 78. Смотрим в словарь. Значение RUN, STOP.
Заполнили текстовое поле в значениях.Зашли в папку 20200102
Номер канала 50, при выборке id словаря 85 Смотрим в словарь. Значение RUN.
Заполнили текстовое поле в значениях.В итоге
2020-01-01 08:00:00, 50, 56, RUN
2020-01-01 09:00:00, 50, 78, STOP
2020-01-01 10:00:00, 50, 56, RUN
2020-01-01 11:00:00, 50, 78, STOP
……
2020-01-02 08:00:00, 50, 85, RUN
2020-01-02 09:00:00, 50, 85, RUN
2020-01-02 10:00:00, 50, 85, RUN
2020-01-02 11:00:00, 50, 85, RUN02.10.2026 в 19:46 #45234manjey73Участник2020-01-02 08:00:00, 50, 85, RUN 2020-01-02 09:00:00, 50, 85, RUN 2020-01-02 10:00:00, 50, 85, RUN 2020-01-02 11:00:00, 50, 85, RUNи вот тут объясни мне прикол писать постоянно RUN ?
Прикол номер два, откуда ты взял
RUNа если там ‘Вася Пупкин нажал RUN’ должно быть ?02.10.2026 в 19:49 #45235manjey73Участникз.ы. при дописывании файла подобным, можно легко обойтись Скриптом кстати.
Вопрос для чего это нужно? чем анализировать и т.д.?
02.10.2026 в 21:28 #45236JurasskParkУчастники вот тут объясни мне прикол писать постоянно RUN ?
Перечитай внимательно два раза первое сообщение и спроси у Google как работает словарь.
И это будет ответ на вопрос.з.ы. при дописывании файла подобным, можно легко обойтись Скриптом кстати.
Это когда тебе известна информация заранее. А когда нет? У меня на производстве есть слово партия, название рецепта. Иногда установки отдаются префиксы CJ_название_партии_рецепт_20261001234545023
02.10.2026 в 21:54 #45237manjey73УчастникДавай начнем сначала.
Метка времени не может повторяться, если мы говорим о словарях и ключах.
Канал тоже не может повторяться.Счетчик? так себе ключ, ни о чем. Это как раз в тему добавления параметра в то, куда ты хочешь
Далее, у тебя 4 значения
2020-01-02 11:00:00, 50, 85, RUN — а это уже словарь Класса, Списка, массива и т.д.
Но никак не словарь Ключ — Значениез.ы. Какая разница, какое значение? если ты знаешь, что в качестве значения СТРОКА и ты знаешь, в какой канал это приходит ?
CJ_название_партии_рецепт_20261001234545023— Это строка определенного канала?Вопросов нет, делаешь массив каналов — канал 1000, длина 20 (хватит тебе для сохранения?)
Далее — убираешь эти каналы из записи в минутки, часовки, дневки и т.д. кроме текущих данных.
Пишешь по изменению в свою текстовую «БД» по изменению.
Метка времени КЛЮЧ, словарь классов или списков классов или ? Значения.Сделать выборку ключей, где есть нужный тебе канал — LINQ
Далее сортируй, показывай и т.д.02.10.2026 в 21:58 #45238manjey73Участник2020-01-02 11:00:00 { [50, RUN], [65, STOP], [10345, CJ_название_партии_рецепт_20261001234545023] } 2020-01-02 12:38:00 { [50, Stop], [10345, CJ_название_партии_ХРЕНЬ_Какая-ТО_61001234545023] }и так далее
50, 65, 10345 — здесь номера каналов, которые на метку времени изменились, остальные не пишем, потому что не менялись
-
Ответ изменён 3 недели назад пользователем manjey73.
03.10.2026 в 09:13 #45240JurasskParkУчастникПро «прикол писать постоянно RUN» и как таблица связана со словарём
Я вижу, что мы говорим о разных вещах, и, кажется, я понял, где корень непонимания. Давай я нарисую схему, а потом отвечу по пунктам.
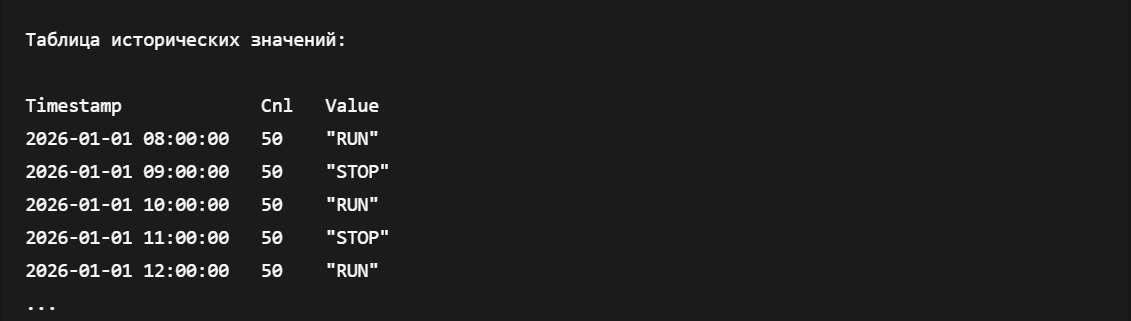
Картинка 1. Что происходит БЕЗ словаря (то, против чего ты возражаешь)
http://jurasskpark.ru/pubimg/up/179100741408584d2.png
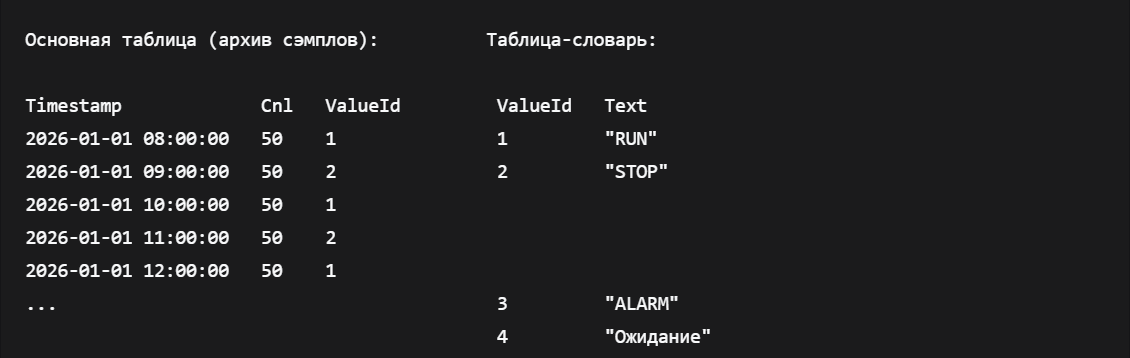
Строка «RUN» физически записана каждый раз. Это то, что ты видишь в своих примерах и против чего справедливо возражаешь. Я с этим не спорю. Я предлагаю ровно противоположное.Картинка 2. Что происходит СО словарём (то, что я предлагаю)
http://jurasskpark.ru/pubimg/up/1791007435d67c050.png
Строка «RUN» записана один раз. В основной таблице — только ValueId = 1 (4 байта). «STOP» — тоже один раз, ValueId = 2.Именно это и есть ответ на вопрос «прикол писать постоянно RUN». Никто не пишет RUN постоянно. Пишется только ValueId, а сам текст живёт в словаре в единственном экземпляре.
Картинка 3. Как это читается при выборке за период
Запрос: «показать канал 50 за 1–2 января».
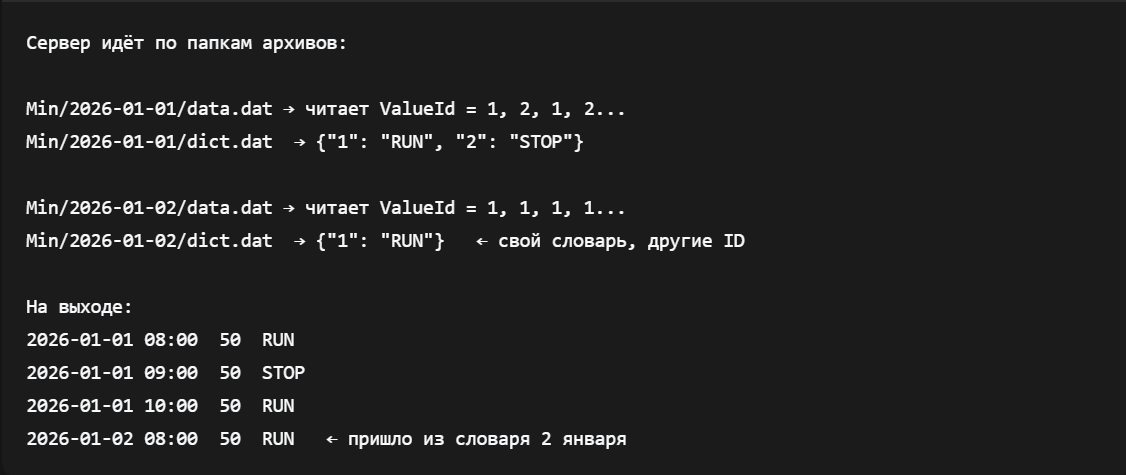
http://jurasskpark.ru/pubimg/up/17910074504bcb1bf.pngValueId = 1 в папке 1 января и ValueId = 1 в папке 2 января — это разные строки в разных словарях. И это не баг, а фича: сервер читает словарь той папки, из которой прочитал сэмпл. Никакой путаницы нет.
Теперь по твоим пунктам
«Прикол писать постоянно RUN?»
См. Картинку 2. RUN пишется один раз. В данных — только 4-байтовый ValueId. Если тег пишется раз в секунду, за сутки:
— Без словаря: 86 400 × 3 байта = ~260 КБ только на одну строку «RUN».
— Со словарём: 1 × 3 байта + 86 400 × 4 байта = ~345 КБ.
Выигрыш появляется, когда строк несколько (RUN/STOP/ALARM) и они повторяются. Чем длиннее строка — тем больше выигрыш. Для строки «CJ_название_партии_рецепт_20261001234545023» (46 байт) выигрыш уже ~11-кратный.Откуда ты взял RUN, а если там «Вася Пупкин нажал RUN»?
Именно для таких длинных строк словарь даёт максимальный эффект. Короткая строка в 3 байта и так компактна. А строка в 46 байт без словаря пишется 46 байт × N раз. Со словарём — 4 байта × N + 46 байт один раз. Для 100 000 событий это 4.6 МБ против 0.4 МБ — разница в 11 раз.
Метка времени не может повторяться, если мы говорим о словарях и ключах. Канал тоже не может повторяться.
Здесь путаница между ключом словаря и ключом таблицы данных.
— В таблице данных ключ — это (Cnl, Timestamp).
— В таблице-словаре ключ — это ValueId. Метка времени там вообще не участвует.
— ValueId — это не счётчик ссылок, а уникальный идентификатор строки внутри дневного словаря.
Это два независимых пространства ключей. Никакого пересечения нет.Счётчик? так себе ключ, ни о чём.
ValueId — это не счётчик. Это первичный ключ словаря, такой же, как TagId в таблице тегов. В словаре дня он уникален, больше нигде не используется и не претендует быть «умным» ключом. Он нужен ровно для одной цели: за 4 байта сослаться на строку.
У тебя 4 значения… а это уже словарь Класса, Списка, массива, а не словарь Ключ — Значение.
Здесь, мне кажется, и есть корень расхождения. Слово «словарь» в программировании — (Dictionary<K,V>) и «словарь» в контексте хранения данных (dictionary encoding) — это разные понятия.
— Dictionary<K,V> — структура данных в памяти.
— Dictionary encoding — приём сжатия, при котором повторяющиеся значения заменяются ссылками на таблицу-справочник. Так работают Parquet, ORC, ClickHouse, InfluxDB и почти все колоночные СУБД.Я предлагаю второе. Это не «словарь классов и списков», это справочник строк, как таблица Tags, только для текстовых значений.
Про твоё предложение
id = id канала, хранить полную строку в отдельной таблице
Это рабочий вариант, но он не дедуплицирует строки между каналами и во времени. Если 50 каналов пишут «RUN», у тебя будет 50 копий «RUN» — по одной на канал. Если канал пишет «RUN» каждую секунду, при выборке за период ты получишь ту же строку тысячу раз — либо в архиве, либо при джойне с таблицей.
Мой вариант отличается одним: ValueId ссылается на строку, а не на канал. Одна строка — один ValueId — независимо от того, сколько каналов её используют и сколько раз она повторяется.
Итого одной фразой
В данных пишется ValueId (4 байта) — не строка. Строка пишется один раз в словарь. Словарь у каждой папки архива свой. ValueId имеет смысл только внутри своей папки. Сервер при чтении подгружает словарь той папки, откуда читает сэмпл. Никаких «постоянно RUN» в данных нет — там только числа.Если после картинок всё ещё остаётся вопрос — напиши, какой именно шаг непонятен, разберём его отдельно.
03.10.2026 в 09:56 #45241manjey73УчастникНу я примерно понял.
То есть приходит строка RUN в некий канал, проверяем ее наличие в текущем словаре, если есть — определили ее id и присваиваем новому каналу.
Если не было, словарь пуст, назначаем id=1.
И так далее по каждой новой поступившей строке в каналы.И ты для этого предлагаешь увеличить штатную бд на 4 байта на канал.
При наличии общих каналов в 30000 и записи раз в секунду
86400*4байта*30000 каналов база вырастет на 10 368 000 000 байт
То есть каждый день, база из 30000 каналов будет больше на 9.887 Мб.Здорово, я на такое тоже не подпишусь 🤣
03.10.2026 в 10:01 #45242manjey73УчастникНасколько я помню, когда общались с Михаилом на счет добавления строк, то он использует упрощенную модель реляционной БД, вернее может не упрощенную, а оптимизированную под задачу самой Scada. И там строго отдается определенное количество байт на поле.
То есть для значения 8 байт (double) и так далее.И добавив еще одно поле ValueId ты автоматом добавишь 4 байта навсегда.
Чем больше каналов в системе, тем больше потеря места.03.10.2026 в 10:08 #45245manjey73Участникв общем, твоя база будет терять 86400*4 байта при записи раз в секунду на КАЖДЫЙ канал в системе, а не на каналы, в которых ты ссылаешься на строковой словарь.
Вот в чем проблема то.
03.10.2026 в 11:52 #45246JurasskParkУчастник86400 × 4 байта × 30000 каналов = 10 368 000 000 байт
Это ~10.37 ГБ, а не «9.887 Мб». 10 368 000 000 байт = 10.37 ГБ ≈ 9.66 ГиБ. У тебя в ответе получились мегабайты, а не гигабайты — расхождение ровно в 1000 раз. Возможно, опечатка, но с такой цифрой дальше спорить сложно: она либо верная, либо нет. Если уж считаем — считаем честно.
Вот тут, мне кажется, и есть корень. Ты рассуждаешь так: «добавили поле ValueId в структуру CnlDataPoint — значит, оно прибавилось к каждой записи каждого канала». Это логично для одной универсальной структуры, где все поля есть всегда.
Но я предлагаю не это. Смотри.
Запись в архиве — не одна универсальная структура. Это набор разных структур для разных типов каналов. Тип канала — это свойство канала, а не сэмпла. Он известен заранее, хранится в дескрипторе канала (в _meta.dat), и никакой флаг в каждом сэмпле не нужен.
Тип канала хранится в _meta.dat ОДИН раз на канал.
Запись в data.dat для числового канала:
[Timestamp: 8][Quality: 2][Val: 8] = 18 байт
↑ не изменилосьЗапись в data.dat для текстового канала:
[Timestamp: 8][Quality: 2][ValueId: 4] = 14 байт
↑ МЕНЬШЕ, чем у числовогоЗапись в data.dat для текстового канала в plain-режиме:
[Timestamp: 8][Quality: 2][len: 2][utf8: N] = 12 + N байтЧисловые каналы не платят ничего. У них ровно те же 18 байт, что и сейчас. 30 000 аналоговых каналов, которые ты привёл в примере, вообще не почувствуют изменений, потому что текст в них не пишется.
Потому что CnlDataPoint — это DTO для чтения, структура в памяти на стороне сервера. Она не совпадает с форматом записи на диск. В памяти удобно держать одно поле, чтобы клиент мог читать и числа, и тексты единообразно. На диск это пишется по-разному в зависимости от типа канала.
Это как раз то, что делает любая колоночная БД: одна логическая схема, разные физические кодировки для разных столбцов.
Проверим на твоём же примере.
Допустим, худший случай: все 30 000 каналов — текстовые и все пишут раз в секунду.Без словаря (plain):
86400 × 30000 × (8 + 2 + 2 + L) байт, где L — длина строки
для L = 10 байт: 86400 × 30000 × 22 = 57 ГБ/суткиСо словарём:
данные: 86400 × 30000 × 14 = 36 ГБ/сутки
словарь: предположим 1000 уникальных строк × 10 байт = 10 КБ (на весь день)
итого: 36 ГБ/суткиРазница: 57 ГБ vs 36 ГБ. Словарь экономит ~37% даже в этом
искусственном сценарии, где каждая строка только один раз в день.А теперь реалистичный случай: 30 000 каналов, из них 100 текстовых, остальные аналоговые.
Без словаря:
аналоговые: 86400 × 29900 × 18 = 46.5 ГБ/сутки (не меняется)
текстовые: 86400 × 100 × 22 = 190 МБ/сутки (если plain)Со словарём:
аналоговые: 86400 × 29900 × 18 = 46.5 ГБ/сутки (не меняется)
текстовые: 86400 × 100 × 14 = 121 МБ/сутки
словарь: ~10 КБЭкономия на текстовых: ~36%. Цена на аналоговых: 0.
Цифра «10 ГБ дополнительно» возникает только если принудительно приписать 4 байта каждому сэмплу каждого канала, независимо от того, есть там текст или нет. Это — strawman. Так делать никто не предлагает, и, конечно, на такое подписываться не надо.
Это, наоборот, аргумент за такой подход, а не против.
Именно потому, что формат фиксированный и типизированный, мы можем позволить себе разные структуры для разных типов каналов. Дескриптор канала уже говорит серверу, какого размера запись ожидать. Числовой канал — 18 байт. Текстовый — 14. Всё детерминировано, всё фиксировано, ничего не «плавает».
ValueId не добавляется к каждой записи. Он заменяет поле Val в записях текстовых каналов, которых в реальной системе — единицы процентов. Числовые каналы (ты сам привёл 30 000 штук) не платят ничего. Если уж считать потери — считай их только для тех каналов, которые реально пишут текст, и для них получится экономия, а не потеря.
03.10.2026 в 12:16 #45247manjey73Участникда, извиняюсь, пользовался онлайн конвертером и не досмотрел. 9,66 Гб каждый день.
Так устроена существующая БД в RapidScada. Собственно как и любая реляционная БД, она требует фиксированный размер поля всегда.так у тебя же получится Timestap, Value, ValueId
[Timestamp: 8][Quality: 2][Val: 8][ValId: 4] = 22 байта — Разве нет? или чего я не понимаю? Как Сервер узнает, что ты добавил id для текста или не добавил?
Или ты говоришь о том, чтобы перелопатить вес код Сервера? 🙂
03.10.2026 в 12:17 #45248manjey73УчастникСобственно кто определяет что из себя представляет канал? числовой он или текстовый?
Сейчас сделано так, все в куче, канал 8 байт, что ты засунешь в эти 8 байт никого не волнует, число, текст или помнится была тема про массив каналов для картинок.Сервер всегда работает только с этими 8-мю байтами, то есть только с одной БД.
-
Ответ изменён 2 недели, 6 дней назад пользователем manjey73.
-
Ответ изменён 3 недели назад пользователем
-
АвторЗаписи
- Для ответа в этой теме необходимо авторизоваться.